Machines vectorielles de soutien (SVM)
Ce tutoriel présente la technique SVM (Support Vector Machine) pour classer les types de morphologie des lits fluviaux en fonction des données de transport hydraulique et sédimentaire. Ce cahier représente un exercice Python étendu pour une application d’apprentissage supervisée avec un modèle non linéaire.
Enable interactive reading and executing code blocks with  and find morphology-predictor-svm.ipynb. Alternatively, install Python and JupyterLab locally and download this Jupyter notebook.
Théorie
Dans le domaine des sciences de la restauration, l’identification de la morphologie fluviale fournit des indications essentielles, par exemple, pour guider la terraformation ciblée visant à rétablir un état quasi naturel d’un paysage fluvial. De plus, les modèles morphologiques peuvent servir de prédicteurs pour estimer le fluvial Transport solide et vice versa. Ainsi, il existe une relation bidirectionnelle entre l’hydraulique fluviale, le transport des sédiments et les modèles morphologiques, qui représentent l’habitat physique des espèces aquatiques et peuvent même affecter la production d’énergie Recking et al., 2016.
Pourtant, la classification et la prédiction de la morphodynamique fluviale sont difficiles en raison de la complexité des écosystèmes fluviaux et de chaque rivière étant un environnement unique. Cependant, il existe des unités morphologiques répétées de rivières ayant des caractéristiques similaires. Un ensemble de fonctionnalités morphologiques répétitives a été introduit par Montgomery & Buffington (1997), et nous nous concentrerons dans ce tutoriel sur les cinq unités morphologiques suivantes (cliquez sur les éléments pour en savoir plus) :
À peu près, ces unités morphologiques suivent l’ordre indiqué ci-dessus le long d’une rivière avec une pente descendante du chenal, depuis les cours d’eau escarpés jusqu’à l’estuaire, bien que les contrôles locaux (p. ex., approvisionnement en sédiments, confinement ou affluents) puissent interrompre cette séquence. Ainsi, les unités pool peuvent généralement être trouvées dans des tronçons de rivière en amont (montagne), tandis que sand beds se trouvent principalement dans des tronçons de rivière de basse altitude, à proximité des estuaires ou des confluents. Notez qu’il y a d’autres unités morphologiques en plus, telles que les eaux douces, les scalles ou les bars Wyrick & Pasternack, 2014. Figure 1 illustre certaines unités morphologiques des rivières près de la nature.
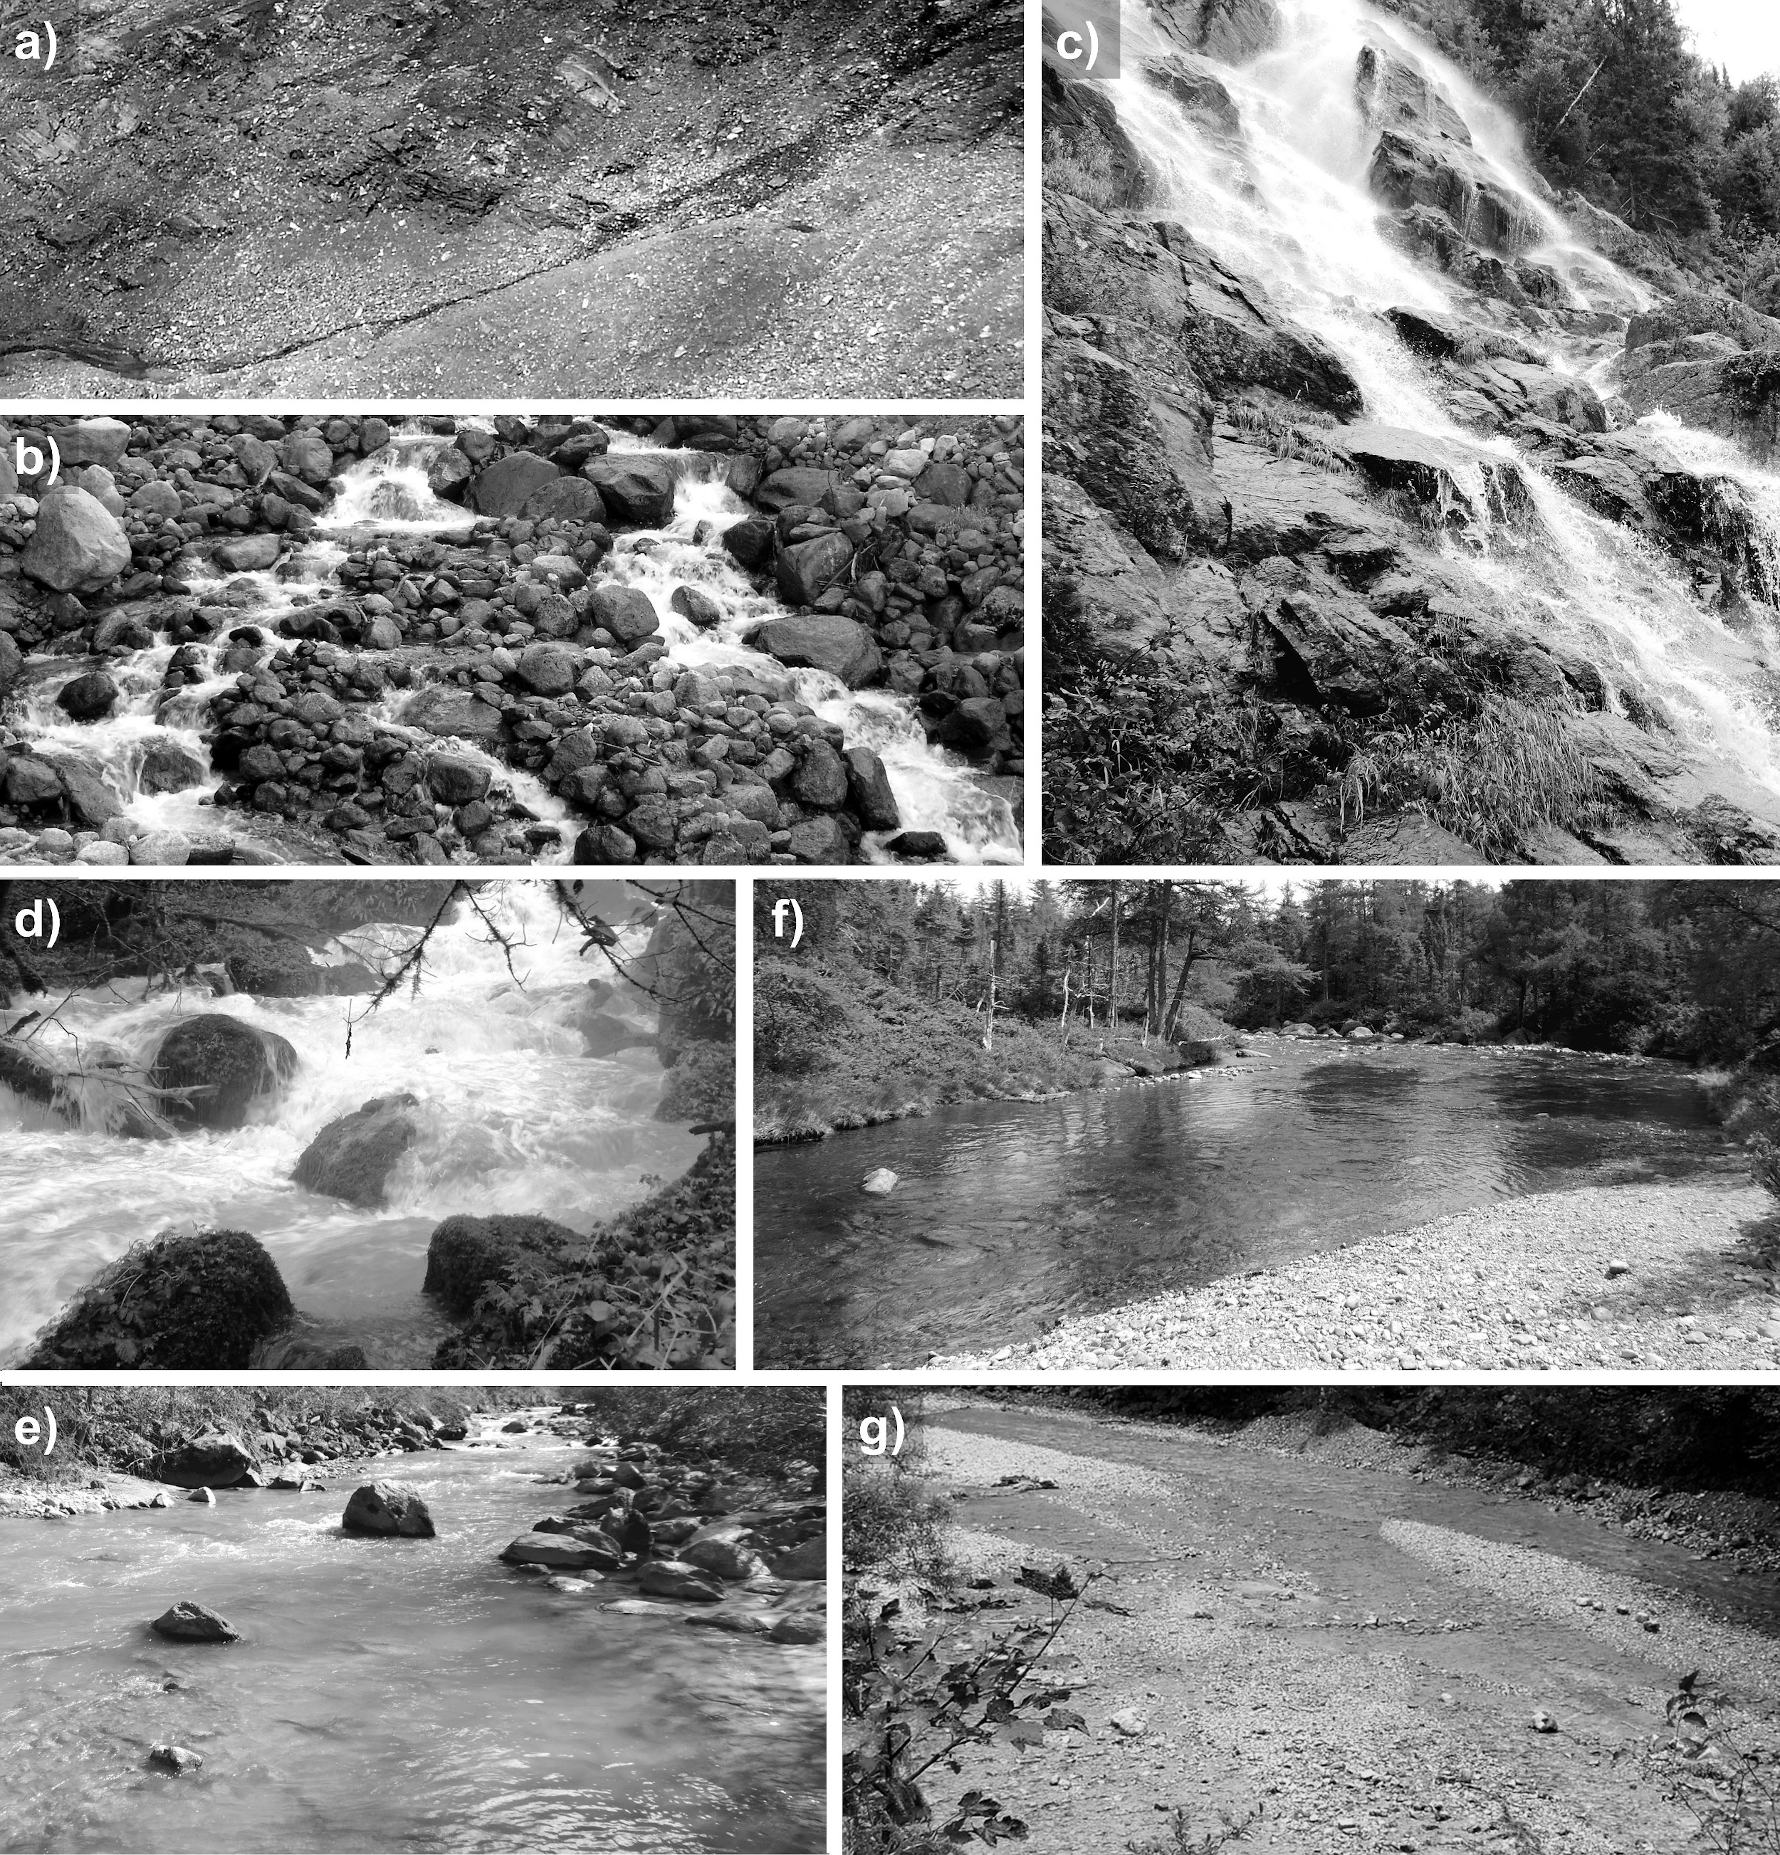
Figure 1:a) Un cours d’eau d’amont colluvial (Furtschaglbach, Autriche), b) un cours d’eau en cascade (Torrent des Favrands, France), c) un cours d’eau rocheux (Anse St-Jean, Québec, Canada), d) un cours d’eau à pool à pas (Dessoubre, France), e) un cours d’eau à lit plat (Dranse, Suisse), f) un cours d’eau à pool à rafales (Le Diable, Québec, Canada), g) un cours d’eau tressé (Jenbach, Allemagne). Source : Schwindt (2017)
To guide restoration actions, experts often visually classify morphological units on-site, though some of them may also be distinguishable on aerial imagery. On-site (in-situ) expert assessments may also serve as ground truth for machine learning models. In this exercise, we will use hydrodynamic parameters with expert-based ground truth from the database https://
Prétraitement
Charger les données
We downloaded a dataset from https://
Les échantillons proviennent de sections de 146 rivières différentes à travers le monde.
L’ensemble de données englobe les paramètres de transport hydraulique et sédimentaire (p. ex., la taille des grains), bien que dans ce tutoriel, nous n’utiliserons que les paramètres suivants pour former le modèle SVM:
W: Largeur du chenal (m)
S: pente du chenal (m/m)
Q : Décharge (m s)
U: Vitesse de débit en vrac (m s)
H: Profondeur d ’ eau (m)
Dans un contexte d’apprentissage automatique, ces paramètres pour prédire les unités morphologiques sont également appelés caractéristiques. La première étape consiste à charger (et afficher) les données sous la forme d’un pandas.DataFrame:
import pandas as pd

data = pd.read_csv("data/bedload_dataset")
dataNettoyer l’ensemble de données
Pour éviter que le modèle SVM ne soit affecté par des statistiques basées sur des entrées absurdes (par exemple, des valeurs de Not-a-Numero NaN) ou des valeurs extrêmes aberrantes, par exemple, résultant de typos, nous appliquerons certaines méthodes de nettoyage.
Supprimer les valeurs de NaN
La première étape de nettoyage est d’enlever NaNs qui pourrait mener plus tard le modèle SVM à de mauvaises conclusions.
# dataset essential info
data.info()
print()

# remove rows that contain at least one NaN value
data.dropna(inplace=True)

# verify that all NaN values were removed
for column in data.columns.to_list():
    print(column, ":", data[column].isnull().any())

# verify final shape of the dataset
print(data.shape)
<class 'pandas.DataFrame'>
RangeIndex: 1067 entries, 0 to 1066
Data columns (total 6 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 W 1067 non-null float64
1 S 1067 non-null float64
2 Q 1067 non-null float64
3 U 1067 non-null float64
4 H 1067 non-null float64
5 Morphology 1067 non-null str
dtypes: float64(5), str(1)
memory usage: 59.7 KB
W : False
S : False
Q : False
U : False
H : False
Morphology : False
(1067, 6)
Rechercher les valeurs aberrantes
Des valeurs aberrantes peuvent survenir dans des environnements extrêmes ou dans des conditions extrêmes (p. ex. précipitations intenses), mais certaines d’entre elles découlent également de défaillances d’équipement qui affecteront les performances du modèle SVM. Il est donc essentiel de reconnaître et de supprimer ces valeurs aberrantes.
Visualiser les caractéristiques dans les diagrammes de dispersion peut être utile pour repérer des candidats aberrants. Le bloc de code suivant crée un graphique scatter de chaque fonction, et marque sa valeur moyenne (ligne horizontale) et la plage des écarts-types ±2 autour (ligne verticale, en supposant une distribution gaussienne).
import numpy as np
import matplotlib.pyplot as plt

# plot visualization parameters
labels = data.columns[0:5].tolist()
colors = ["crimson", "purple", "limegreen", "gold", "blue"]
width = 0.5
rng = np.random.default_rng(42)  # seed for a reproducible horizontal jitter

# one subplot per feature because the features have different units and magnitudes
fig, axes = plt.subplots(1, len(labels), figsize=(12, 4))
for ax, label, color in zip(axes, labels, colors):
    x = rng.random(data.shape[0]) * width - width / 2.
    ax.scatter(x, data[label], color=color, s=8)
    mean = data[label].mean()
    std = data[label].std()
    ax.plot([-width / 2., width / 2.], [mean, mean], color="k")
    ax.plot([0, 0], [mean - 2 * std, mean + 2 * std], color="k")
    ax.set_xticks([])
    ax.set_xlabel(label)

fig.tight_layout()
plt.show()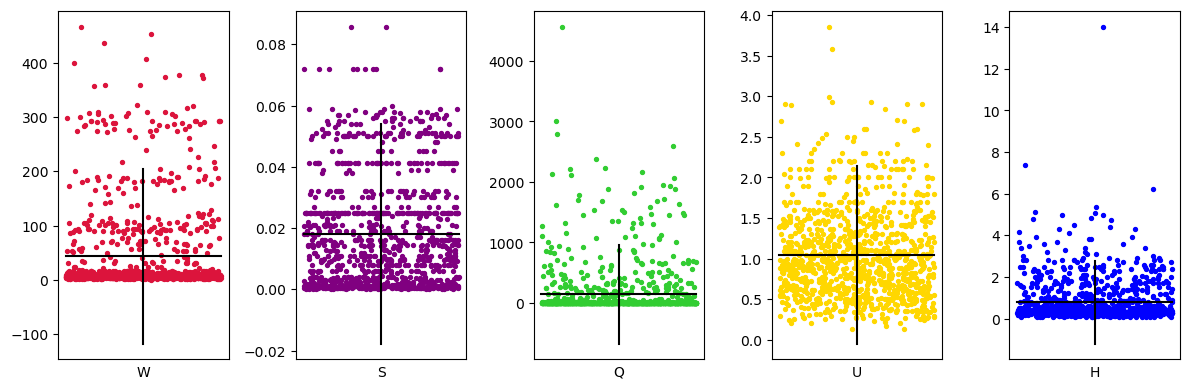
Supprimer les valeurs aberrantes
Les valeurs aberrantes peuvent être supprimées avec deux méthodes différentes:
Manuel (c.-à-d. jugement d’expert): identifier les aberrations des caractéristiques et les supprimer en fixant des limites de leur intervalle.
Automatisé : suppose une distribution de probabilité et fixe des limites basées sur une faible probabilité d’occurrence.
Le bloc de code suivant implémente ces deux méthodes (manuelles-experts et automatisées). La suppression manuelle aberrante est hard-coded car les limites doivent être données par des experts.
L’approche automatisée (en dessous de l’énoncé else) suppose que les données suivent une distribution gaussienne, et supprime les points de données avec un soi-disant z-score de plus de 4 (quatre) en termes absolus. Le z-score exprime par combien d’écarts-types une valeur s’écarte de la moyenne. Pour une distribution gaussienne, environ 99,94 % de toutes les valeurs se situent dans quatre écarts types par rapport à la moyenne. Ainsi, un échantillon dont la probabilité d’occurrence est inférieure à 0,01 % est automatiquement considéré comme un échantillon aberrant et retiré de l’ensemble de données. À cette fin, nous utilisons la fonction zscore de la bibliothèque scipy.
from scipy.stats import zscore
# choose the method to remove outliers
# remove_method = "expert_analysis"
remove_method = "zscore"

if "expert" in remove_method:
    data = data.loc[(data["Q"] < 2000) &
                    (data["W"] < 250)]
else:
    data = data[(np.abs(zscore(data.loc[:, data.columns != "Morphology"])) < 4).all(axis=1)]

# work on an independent copy of the filtered rows (avoids chained assignment issues)
data = data.copy()
dataVérifier les proportions des classes
Un modèle d’apprentissage automatique exige que les données de vérité au sol respectent certaines normes de qualité. Celles-ci concernent (entre autres):
Chaque modèle a besoin d’un nombre minimum d’échantillons différent pour avoir une signification statistique](Statistical significance). Il n’est pas trivial d’identifier le nombre minimum d’échantillons qui donnent un modèle digne de confiance. Cependant, pour représenter correctement une classe (quel que soit le sens), la soi-disant distribution de fréquence de chaque fonction doit être similaire à la distribution de fréquence.
Avoir plus de 30 samples lorsqu’il s’agit de variables normalement distribuées est une règle de bonne pratique.
Idéalement, les classes utilisées pour un problème de classification devraient être représentées par un nombre similaire d’échantillons. Un ensemble de données déséquilibré peut produire un modèle qui donne la préférence à une classification correcte de la classe avec un plus grand nombre d’échantillons. Ceci est une conséquence de l’utilisation de la précision comme mesure de performance. La précision est le rapport entre les prévisions correctes et le nombre total de prévisions (). En favorisant le nombre total de prédictions correctes par rapport à une prédiction équilibrée, la précision masque l’importance de prédire correctement les classes sous-représentées. Par conséquent, les mesures sensibles aux classes, telles que précision et rappel, sont préférables pour mesurer la performance des modèles formés sur des données déséquilibrées.
Les solutions pour équilibrer les échantillons déséquilibrés englobent :
Recueillir de nouvelles données ou générer des données synthétiques (par exemple, en suréchantillonnant les classes sous-représentées ou en utilisant Monte Carlo methods).
Weighting classes, qui signifie attribuer des poids plus élevés aux classes sous-représentées pour augmenter leur importance dans le processus de formation. L’effet des coefficients de pondération ou des seuils de décision sur le compromis entre les taux réels et les taux faux positifs peut être évalué à l’aide d’une courbe ROC courbe.
Dans ce tutoriel, les échantillons peuvent être considérés comme équilibrés, sauf pour la classe de lit de sable (voir la sortie ci-dessous). La pondération et les courbes ROC ne sont pas considérées ici. Si la sensibilité et la spécificité de la classe de banc de sable étaient acceptables lors de la classification des données d’essai, le modèle pourrait également être utilisé pour la classification des bancs de sable sans qu’il soit nécessaire de recourir à des techniques d’équilibrage.
data["Morphology"].value_counts()Morphology
Step-pool 247
Plane Bed 243
Riffle-pool 241
Braiding 228
Sand bed 79
Name: count, dtype: int64Nouveaux prédicteurs dérivés
Il est parfois possible de calculer de nouvelles fonctionnalités significatives à partir des fonctionnalités existantes. Par exemple, les prédicteurs connus de la morphologie sont :
le produit de la pente (énergie) (-), la vitesse de débit en vrac (m/s) et la profondeur d’eau (m), qui est proportionnelle à la puissance spécifique du courant (W/m), où est la densité de l’eau et est l’accélération gravitationnelle; de même, le produit de et est proportionnel à la bed shear stress
le ratio de décharge (m/s) et la largeur (m), qui est la décharge de l’unité (m/s)
# compute new columns for the new features SUH and Q/W
data["SUH"] = data["S"] * data["U"] * data["H"]
data["Q/W"] = data["Q"] / data["W"]
dataVérifier la multicolinéarité
Des caractéristiques connexes (c.-à-d. des paramètres de mesure statistiquement dépendants) peuvent donner lieu à des modèles peu fiables. Par exemple, considérez un scientifique qui veut utiliser des modèles d’apprentissage automatique (ML) pour prédire le nombre de touristes qui se font brûler le soleil au Brésil pendant leurs vacances. Elle veut utiliser l’intensité du rayonnement solaire et le nombre de scoops de crème glacée vendus comme caractéristiques. Le scientifique peut trouver que les deux caractéristiques sont pertinentes pour prédire le nombre de touristes brûlés au soleil, mais la raison de cette constatation est que le nombre de scoops de crème glacée vendus et l’intensité du rayonnement solaire sont corrélés. Ainsi, le scientifique n’a aucun moyen de connaître l’importance réelle de chaque caractéristique dans la prédiction des touristes brûlés par le soleil parce que les caractéristiques croissent et diminuent simultanément. D’ailleurs, la consommation de crème glacée ne provoque pas de coups de soleil (ou vice versa); les deux sont motivés par une cause commune (soleil), mais c’est un autre sujet.
À cette fin, il est important d’étudier la corrélation entre les caractéristiques et d’envisager d’éliminer les caractéristiques corrélées pour produire un modèle plus fiable. Une façon de repérer visuellement la colinéarité est de tracer la combinaison de deux variables dans un graphique de dispersion. À cette fin, la figure ci-dessous aide à repérer les aspects suivants de la bedload_dataset:
Il existe une forte corrélation linéaire entre les fonctionnalités et , ce qui n’est pas surprenant parce que .
Il n’y a qu’une faible corrélation linéaire entre et (coefficient de corrélation d’environ 0,37, voir la carte de chaleur ci-dessous).
La vitesse d’écoulement distribution est à peu près en forme de cloche (voir diagonale principale).
import seaborn as sns

# plot scatter of the 2d (two-dimensional) combination of features
sns.pairplot(data.loc[:, data.columns != "Morphology"])
plt.show()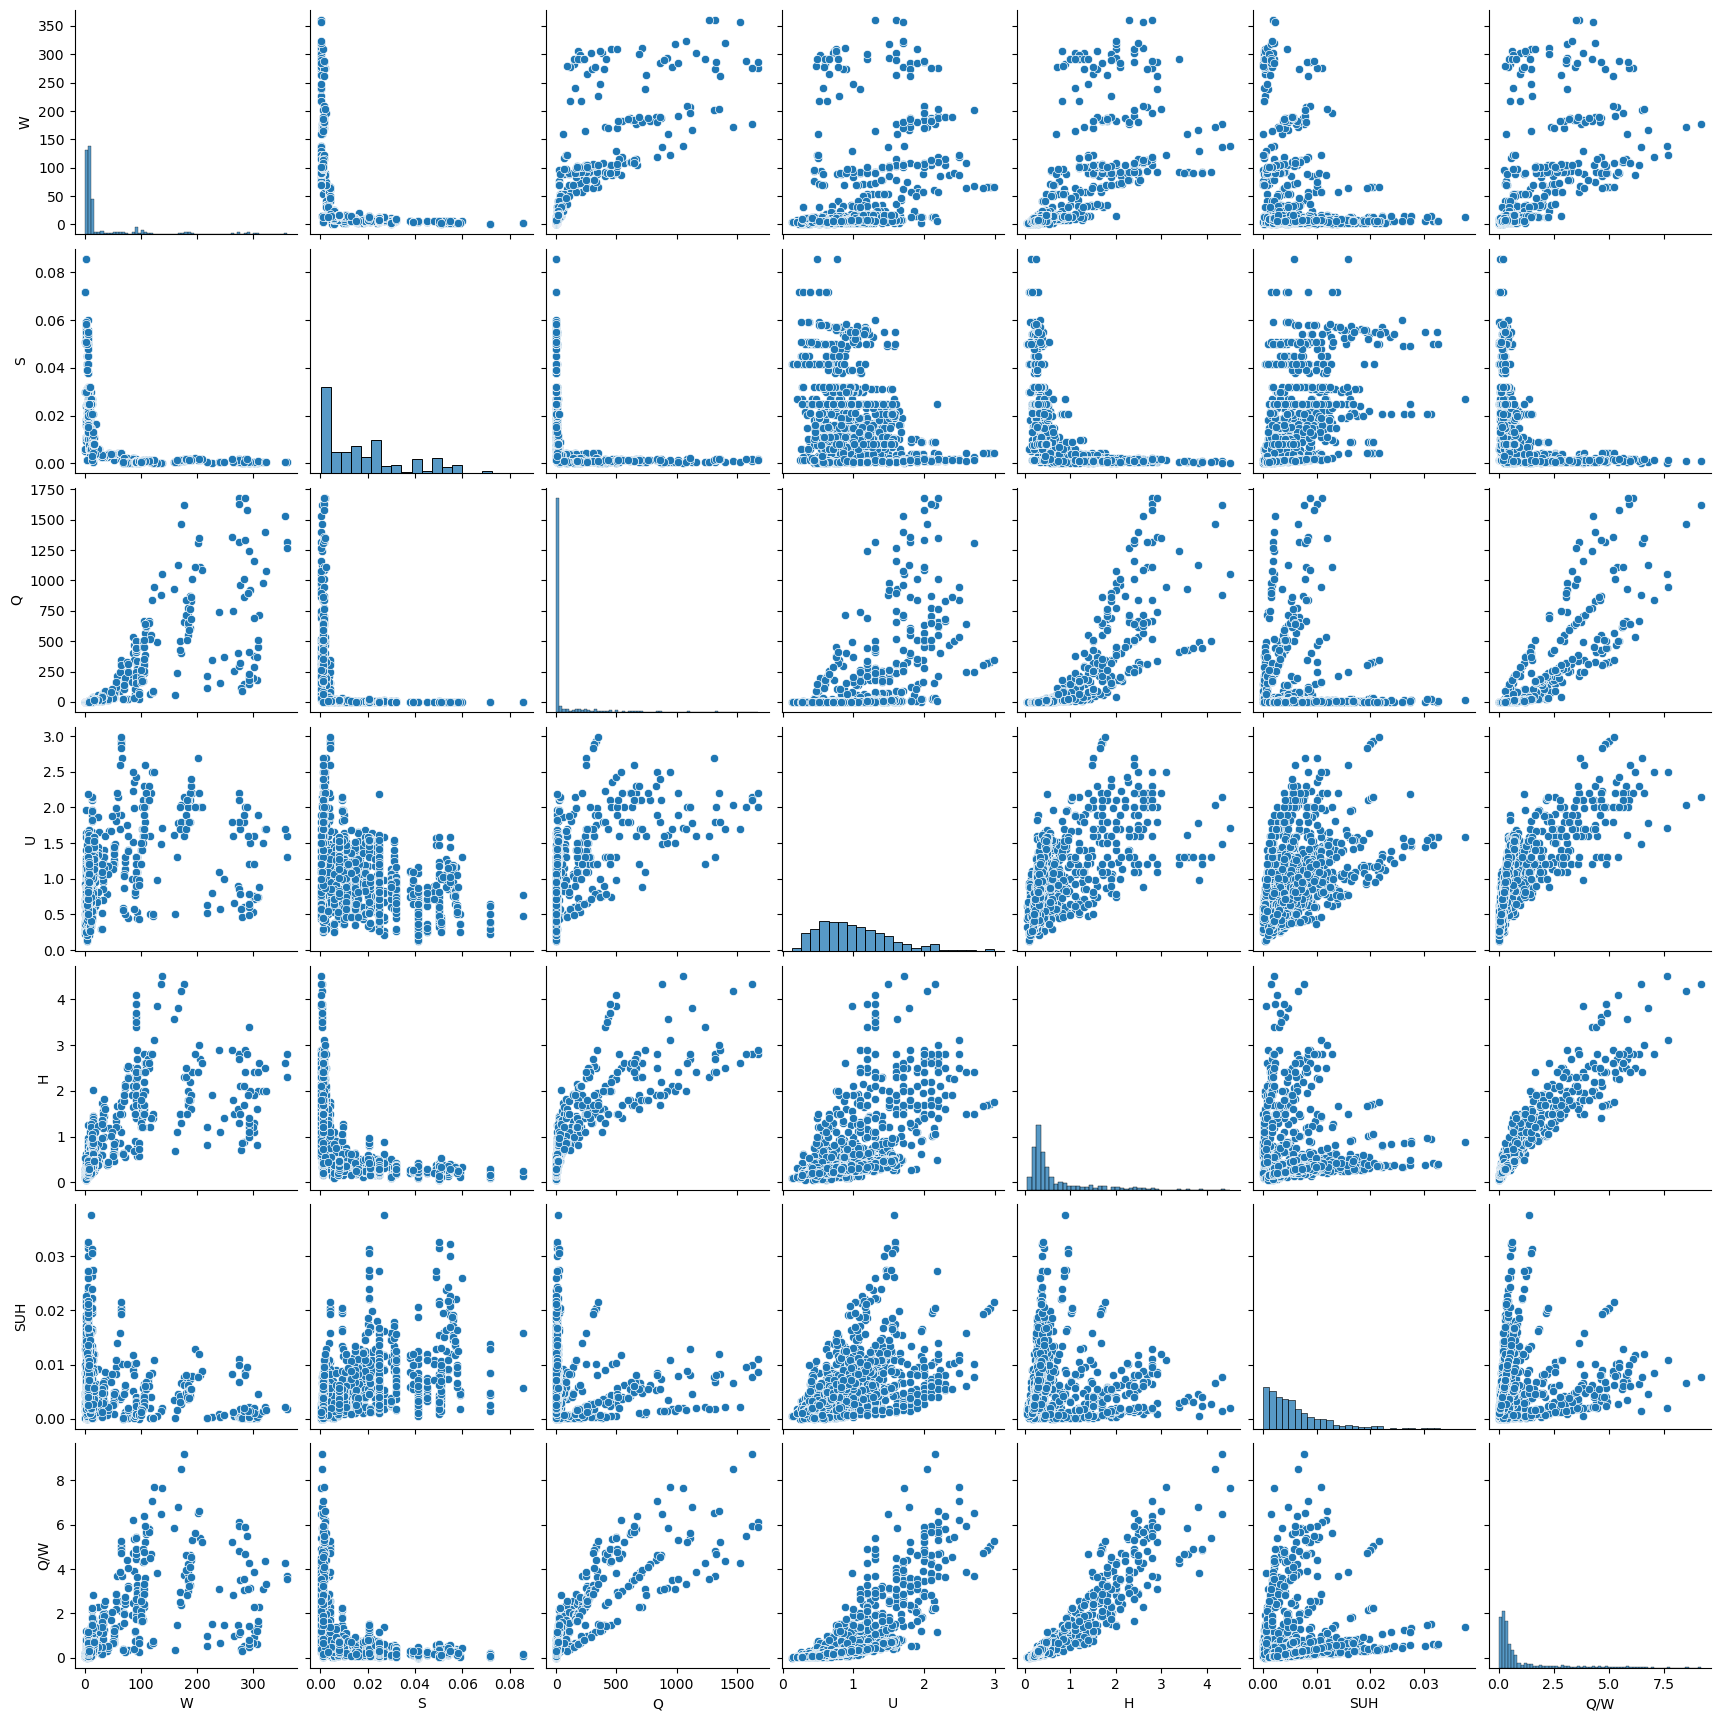
De plus, une heatmap est une autre méthode efficace pour visualiser la corrélation linéaire entre les caractéristiques. De plus, le calcul de correspondance linéaire permet une analyse quantitative.
# verify linear correlation
feature_corr_df = data.loc[:, data.columns != "Morphology"].corr()
mask = np.zeros_like(feature_corr_df, dtype=bool)
mask[np.triu_indices_from(mask)] = True
sns.heatmap(feature_corr_df,
            annot=True,  # print value inside the grid
            mask=mask  # mask values (boolean matrix)
            )
plt.show()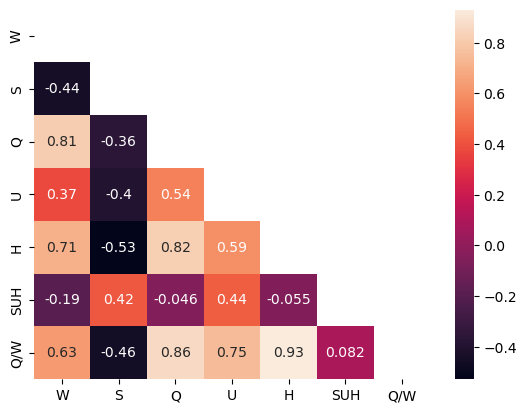
Facteur d’inflation variable (VIF)
Une méthode simple pour évaluer multicollinéarité est de calculer le facteur d’inflation de variance (VIF) pour chaque fonction, ce qui permet de quantifier dans quelle mesure une fonction peut être expliquée par les autres fonctions.
La première étape pour calculer le FIV consiste à traiter une fonction comme une variable dépendante](https://
Enfin, le FIV peut être calculé pour chaque fonction avec l’équation suivante:
est le facteur d’inflation de la fonction -th, et
est le coefficient de détermination résultant de la régression linéaire de la fonction -th sur toutes les autres fonctionnalités.
Notez que le plus grand (i.e., le meilleur le modèle de régression linéaire), le plus grand est l’inflation. En d’autres termes, les grandes valeurs de la FIV indiquent une corrélation élevée entre la caractéristique considérée et l’une des autres caractéristiques. Pourtant, il n’est pas possible de dire sur la base du VIF seulement, qui autre fonctionnalité fait gonfler le VIF.
En règle générale, un VIF supérieur à 10 (dix) indique un ensemble de caractéristiques inappropriées pour produire un modèle ML fiable. Idéalement, le FIV devrait rester inférieur à 5 (cinq), ce qui est considéré comme une corrélation modérée Franke, 2010. Toutefois, ces valeurs de référence ne sont pas une règle générale et toujours applicable. Un VIF égal ou supérieur à 10 peut encore donner un bon modèle.
Une analyse plus approfondie de l’impact d’un FIV élevé sur les caractéristiques corrélées peut être effectuée en supprimant une caractéristique à la fois et en étudiant comment la suppression de la fonctionnalité affecte la variation de l’erreur standard et p-value du modèle.
Dans ce tutoriel, 2 fonctionnalités ont un VIF 10 (notamment et ), comme l’indique le bloc de code suivant.
from sklearn.linear_model import LinearRegression

# compute VIF for the features
def calculate_vif(df, features):
    vif = {}

    for feature in features:
        # extract all the other features you will regress against
        X = [f for f in features if f != feature]
        X, y = df[X], df[feature]

        # extract r-squared from the fit
        r2 = LinearRegression().fit(X, y).score(X, y)

        # compute VIF
        vif[feature] = 1 / (1 - r2)
    # return VIF DataFrame
    return pd.DataFrame({"VIF": vif})

# call function calculate_vif with features as input
calculate_vif(df=data,
features=data.columns[data.columns != "Morphology"].to_list())Supprimer les fonctionnalités pour réduire VIF
Dans le but de réduire les FIV à moins de 5, nous utilisons une approche d’essai et d’erreur dans ce tutoriel. Modifier le bloc de code ci-dessous montre que supprimer et est suffisant pour réduire les FIV des fonctionnalités restantes à moins de 5. En particulier, ces deux variables supprimées entrent également dans les fonctionnalités présentées ci-dessus et . Ainsi, bien que et soient supprimés, ils continuent de “contribuer l’information” au modèle final.
La combinaison de caractéristiques corrélées pour en produire une nouvelle, puis pour les éliminer, est une approche commune pour réduire les FIV. Puisque nous avons obtenu de bonnes valeurs de FIV en supprimant certaines caractéristiques, aucune analyse supplémentaire n’est nécessaire.
Enfin, les caractéristiques qui sont utilisées pour former et tester le modèle SVM sont indiquées par la sortie du bloc de code ci-dessous.
# trial-and-error approach: remove features to get VIFs < 5
data = data.loc[:, (data.columns != "H") & (data.columns != "Q")]

# compute VIF again to verify if VIFs are less than 5
calculate_vif(df=data,
features=data.columns[data.columns != "Morphology"].to_list())Séparer les ensembles de données d ’ essai et de formation
La dernière étape de préparation à la construction du modèle SVM est de tirer une formation et un ensemble de données d’essai de l’ensemble bedload_dataset. Choisir une part des données pour composer une formation et un ensemble de données de test est généralement un choix heuristique. Ici, nous utilisons 30 % des données pour tester une hypothèse finale plus tard. Notez que dans les ensembles de données fractionnés, les indices des échantillons (lignes des données tabulaires) correspondent aux indices de leurs classes dans les ensembles de données cible .
from sklearn.model_selection import train_test_split


# split dataframes with features and labels only
labels = data.loc[:, "Morphology"]
predictors = data.loc[:, data.columns[data.columns != "Morphology"]]

# split testing set as 30% of the data
# X corresponds to the features (matrix form)
# y corresponds to the labels (vector form)
X_train, X_test, y_train, y_test = train_test_split(predictors,
                                                    labels,
                                                    test_size=0.3,
                                                    random_state=42  # seed for random selection of data
                                                    )

# visualize training and testing sets
print("TRAINING DATASET PREDICTORS")
print(X_train.head(), "\n")
print("dataframe size", X_train.shape, "\n")
print("------------------------------------------")
print("TRAINING DATASET TARGET")
print(y_train, "\n")
print()
print("------------------------------------------------------------------------------------\n")

print("TESTING DATASET PREDICTORS")
print(X_test.head())
print("dataframe size", X_test.shape, "\n")
print("------------------------------------------")
print("TESTING DATASET TARGET")
print(y_test.head())
print("Vector size", y_test.shape)
TRAINING DATASET PREDICTORS
W S U SUH Q/W
256 6.91 0.01100 1.02 0.003366 0.277858
397 88.09 0.00210 1.99 0.008149 3.889545
586 14.02 0.02070 1.34 0.022190 1.078459
526 218.00 0.00041 0.52 0.000175 0.541284
9 8.00 0.02000 1.18 0.007316 0.370000
dataframe size (726, 5)
------------------------------------------
TRAINING DATASET TARGET
256 Plane Bed
397 Plane Bed
586 Step-pool
526 Sand bed
9 Riffle-pool
...
89 Riffle-pool
337 Plane Bed
476 Plane Bed
123 Riffle-pool
876 Braiding
Name: Morphology, Length: 726, dtype: str
------------------------------------------------------------------------------------
TESTING DATASET PREDICTORS
W S U SUH Q/W
203 2.57 0.01040 1.58 0.008216 0.793774
937 105.00 0.00096 1.90 0.002918 3.076190
546 93.00 0.00050 1.10 0.001320 2.688172
214 53.04 0.00380 1.44 0.004596 1.211916
312 6.28 0.02020 0.34 0.001511 0.074841
dataframe size (312, 5)
------------------------------------------
TESTING DATASET TARGET
203 Riffle-pool
937 Braiding
546 Sand bed
214 Riffle-pool
312 Plane Bed
Name: Morphology, dtype: str
Vector size (312,)
Construire le modèle SVM
Principe de fonctionnement
Une machine vectorielle de soutien (SVM) est un algorithme d’apprentissage qui recherche un soi-disant hyperplan qui sépare de façon optimale les classes de fonctionnalités. Pour trouver une séparation optimale, l’algorithme essaie de maximiser la distance (ou la marge) entre l’hyperplan et les points de données les plus proches. Les points de données situés sur (ou à l’intérieur) les limites de la marge sont également libellés ** vecteurs de soutien** parce qu’ils fonctionnent comme une référence à draw l’hyperplan (voir Figure 2 ci-dessous).
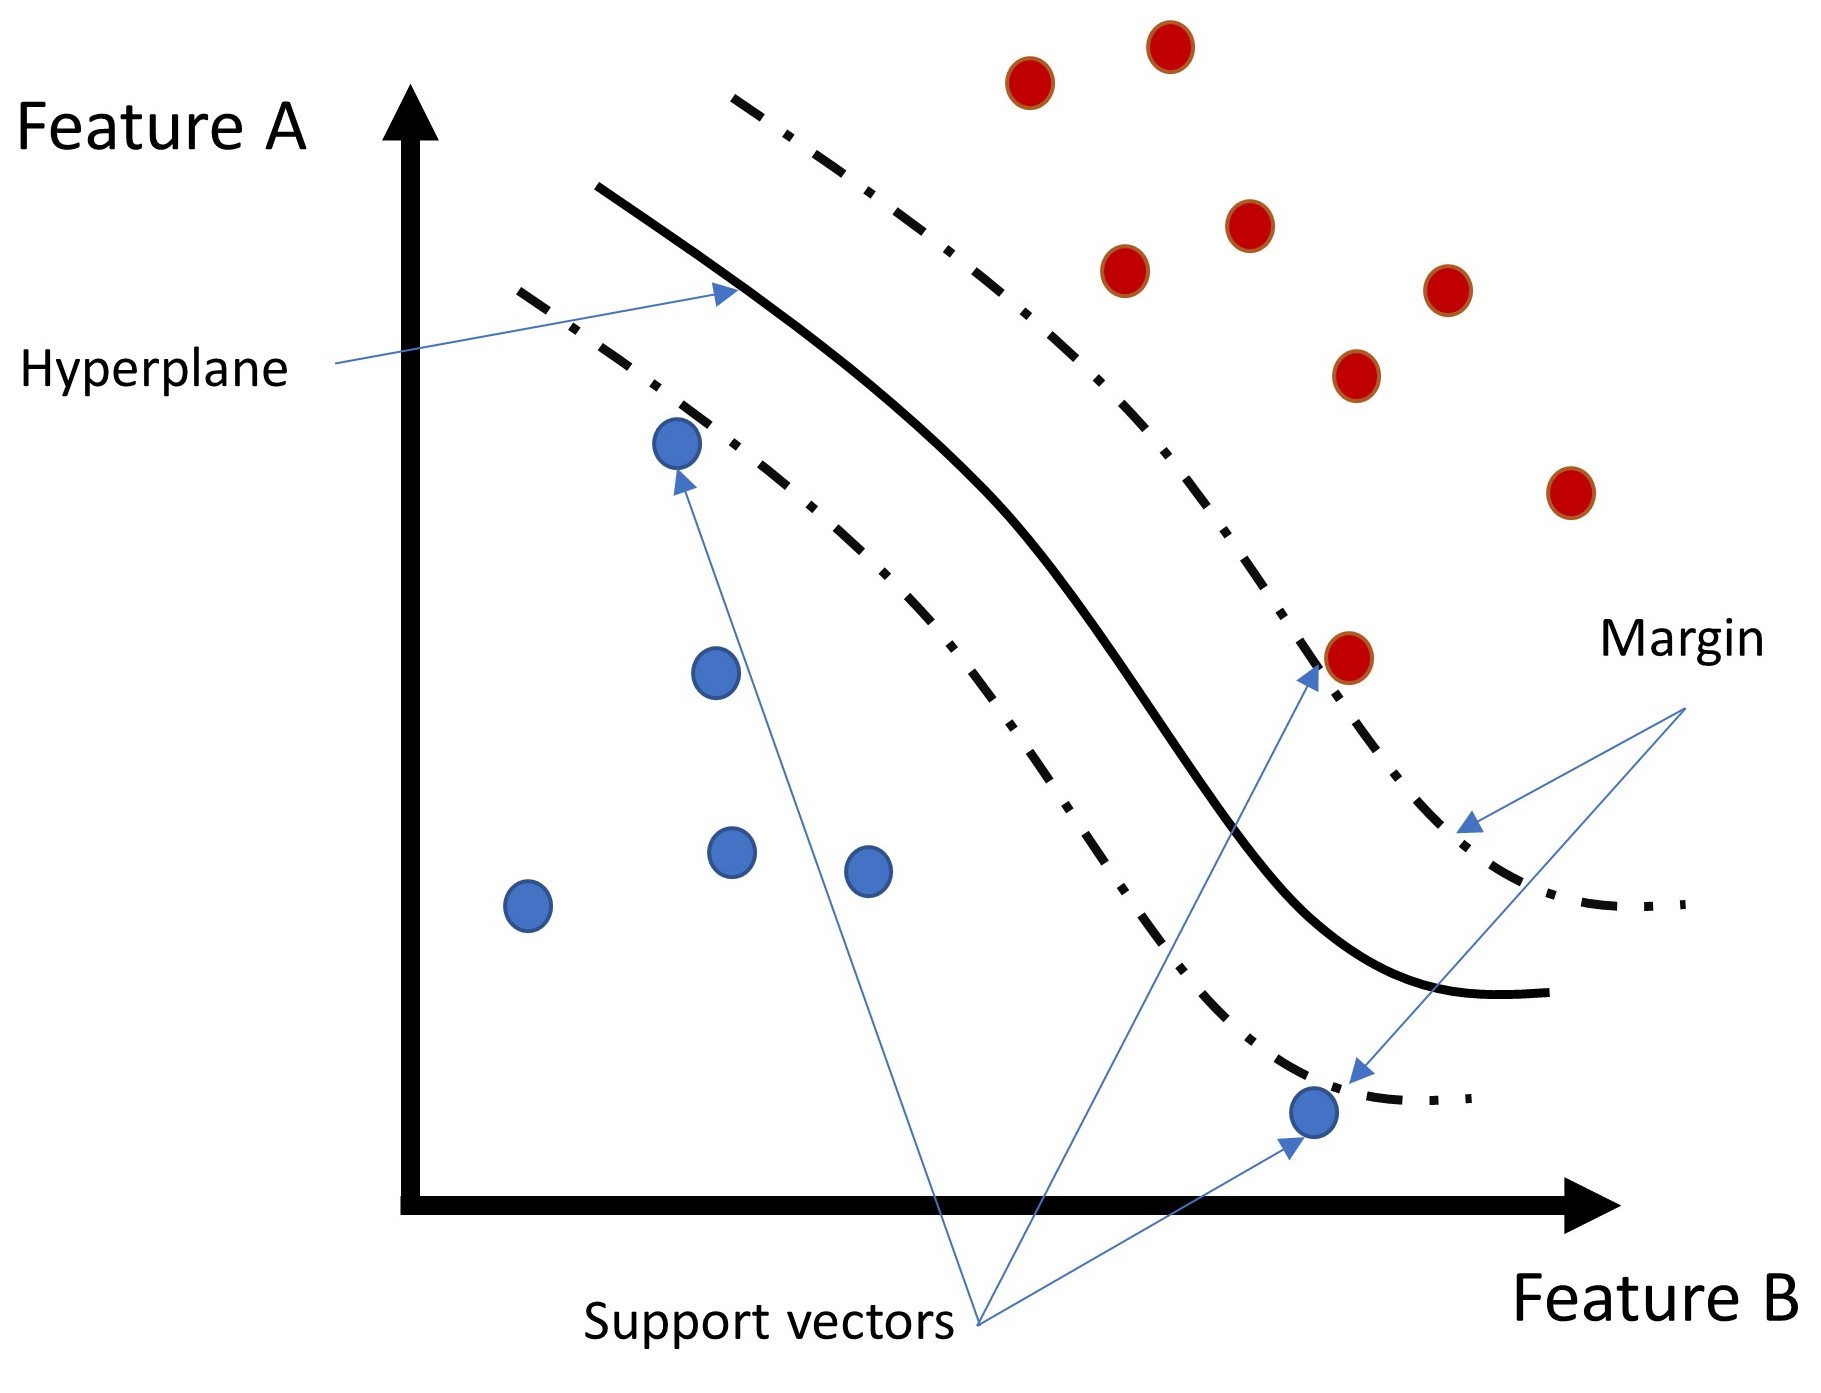
Figure 2:Illustration d’un hyperplan et marges d’un SVM. Source: Ricardo Barros
Par exemple, supposons que deux des classes ci-dessus sont linéairement séparables. L’hyperplan de séparation est défini par , et les régions qui contiennent chaque classe peuvent être définies comme suit:
--> Class Red , et --> Class Blue
où
est le vecteur des poids (normal à l’hyperplan),
est le vecteur caractéristique d’un échantillon,
est l’interception (également appelée bias), et
la valeur de 1 est une convention d’échelle, puisque et peut être multipliée par n’importe quel facteur positif sans changer l’hyperplan.
Avec cette convention, la largeur de marge est . Ainsi, maximiser la marge (après certaines étapes qui ne sont pas abordées ici) correspond à minimiser l’expression suivante :
où est le vecteur de poids transposé, sous réserve de la contrainte que tous les échantillons d’entraînement se trouvent du bon côté de la marge.
Dans le monde réel, cependant, il est courant de trouver des problèmes où les classes ne sont pas linéairement séparables. Dans de telles situations, on peut appliquer ce qu’on appelle les kernels. Un noyau est une fonction qui cartographie implicitement les fonctionnalités dans un espace aux dimensions plus élevées (c.-à-d. de nouvelles fonctionnalités qui sont des combinaisons des fonctionnalités disponibles), où les classes peuvent devenir linéairement séparables. L’astuce kernel rend cela possible sans calculer explicitement les nouvelles fonctionnalités.
Ici, nous appliquons le noyau Radial Base Function (RBF). Le RBF est un noyau populaire parce qu’il cartographie implicitement dans un espace infiniment dimensionnel, ce qui le rend très flexible. Cependant, cette flexibilité signifie également qu’un RBF-SVM peut suradapter les données de formation lorsque ses paramètres ne sont pas soigneusement ajustés (voir la section suivante).
validation croisée du coefficient k
Les SVM avec un noyau RBF peuvent être ajustés avec deux paramètres :
C : détermine la validité des marges. Il différencie entre une marge ** dure** (c’est-à-dire une marge qui permet une faible ou aucune pénétration des points de données) et une marge ** molle** (c’est-à-dire une marge qui permet la pénétration des points de données à l’intérieur de la marge). Un C supérieur correspond à une marge plus dure.
gamma : détermine la région de similitude entre les échantillons. C’est le seul paramètre du noyau RBF. Le gamma le plus élevé est, le plus étroit est l’influence d’un échantillon marqué sur le classement d’un nouvel échantillon (c.-à-d. que seuls des échantillons très proches sont considérés comme semblables).
Les marges rigides peuvent également être interprétées comme étant la sensibilité ** de l’hyperplan** lorsqu’on les adapte aux données. Plus la marge est dure, plus l’hyperplane tourne pour ne permettre à aucun point de données de pénétrer la marge. Ainsi, un C élevé et un gamma élevé augmentent le risque de surajustement.
Dans ce tutoriel, nous définissons C en fonction d’une approche d’essai et d’erreur et gamma en fonction d’une validation croisée. Le bloc de code suivant construit le SVM à l’aide de la bibliothèque sklearn, et trace les courbes d’erreur de validation et de formation résultant de différentes gamma .
from sklearn.svm import SVC
from sklearn.model_selection import validation_curve


# define C, gamma range, kernel and number of cross-val. folds
param_range = np.logspace(-5, 3, 13)  # gamma values to test
C = 500  # chosen hyperparameter through tuning
kernel = "rbf"  # radial basis function
n_of_folds = 5

# perform 5-fold cross-validation and save training and validation error
train_scores, test_scores = validation_curve(SVC(kernel=kernel,
                                                 C=C),
                                             X_train,
                                             y_train,
                                             param_name="gamma",
                                             param_range=param_range,
                                             scoring="accuracy",
                                             cv=n_of_folds
                                             )

# convert accuracy into error
train_error = 1 - train_scores
validation_error = 1 - test_scores

# compute 5-fold cross-validation mean and std of error
train_error_mean = np.mean(train_error, axis=1)
train_error_std = np.std(train_error, axis=1)
validation_error_mean = np.mean(validation_error, axis=1)
validation_error_std = np.std(validation_error, axis=1)

#-------------------------------------------------------------------

# visualization of training and error validation
plt.title("Validation Curve with SVM")
plt.xlabel(r"$\gamma$")
plt.ylabel("Error (1-accuracy)")
plt.ylim(-0.01, 1.1)
lw = 2
plt.semilogx(
    param_range, train_error_mean, label="Training error", color="darkorange", lw=lw
)
plt.fill_between(
    param_range,
    train_error_mean - train_error_std,
    train_error_mean + train_error_std,
    alpha=0.2,
    color="darkorange",
    lw=lw,
)
plt.semilogx(
    param_range, validation_error_mean, label="Cross-validation error", color="navy", lw=lw
)
plt.fill_between(
    param_range,
    validation_error_mean - validation_error_std,
    validation_error_mean + validation_error_std,
    alpha=0.2,
    color="navy",
    lw=lw,
)
plt.legend(loc="best")
plt.show()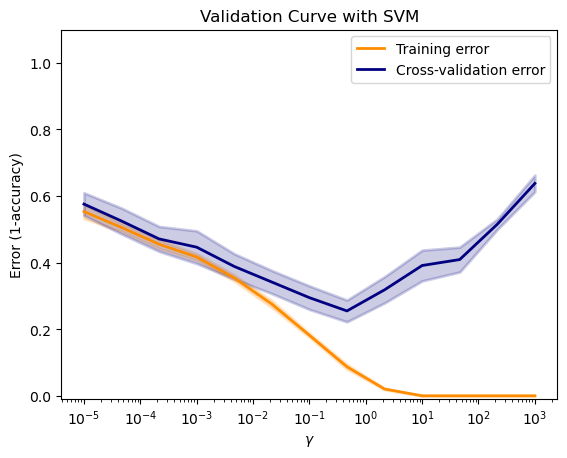
Choisir des paramètres optimaux
La décision sur les paramètres optimaux pour le SVM dépend de votre jugement. Aux fins de la sélection des paramètres optimaux dans ce tutoriel, le bloc de code ci-dessous quantifie le tracé ci-dessus (en particulier la courbe bleue) sous forme de tableau et enregistre le gamma qui produit la plus petite erreur ( gamma opt ).
# save optimal gamma
index_min = int(np.argmin(validation_error_mean))
validation_error_min = validation_error_mean[index_min]
gamma_opt = param_range[index_min]  # gamma that gives minimum validation error

# visualize error evolution with gamma
columns = ["Mean validation error", "gamma"]
array = np.array([validation_error_mean, param_range]).transpose()

print(pd.DataFrame(array, columns=columns), "\n")
print("Minimum mean validation error:", validation_error_min)
print("optimal gamma:", gamma_opt)
Mean validation error gamma
0 0.575739 0.000010
1 0.524856 0.000046
2 0.471101 0.000215
3 0.446311 0.001000
4 0.388474 0.004642
5 0.341606 0.021544
6 0.294709 0.100000
7 0.254861 0.464159
8 0.318262 2.154435
9 0.391252 10.000000
10 0.409173 46.415888
11 0.515144 215.443469
12 0.637789 1000.000000
Minimum mean validation error: 0.2548606518658479
optimal gamma: 0.46415888336127725
Modèle SVM d’hypothèse optimale du train
Après avoir défini un gamma donnant la plus petite erreur de validation ( gamma opt ), nous pouvons former une hypothèse optimale ( h opt ) sur l’ensemble des données de formation. En outre, nous pouvons évaluer la précision du modèle en l’utilisant pour classer l’ensemble de données de test. Le bloc de code ci-dessous présente la procédure de formation, l’ajustement du SVM (c’est-à-dire une hypothèse optimale) et imprime l’erreur de l’hypothèse optimale sur l’ensemble de données d’essai.
# train optimal model and evaluate accuracy
h_opt = SVC(kernel=kernel,
            gamma=gamma_opt,
            C=C)  # instantiate optimal model
h_opt.fit(X_train, y_train)  # train the model with entire training set
print("Error (1-Accuracy) of h_opt on testing data: \n -->>", 1 - h_opt.score(X_test, y_test))
Error (1-Accuracy) of h_opt on testing data:
-->> 0.19551282051282048
Évaluation des résultats (matrice de confusion)
Enfin, le bloc de code suivant génère la soi-disant matrice confusion pour évaluer la performance optimale du modèle d’hypothèse lors de la classification des échantillons avec des morphologies distinctes. La matrice de confusion utilise le nombre total d’échantillons et visualise leurs unités morphologiques vraies et prédites.
from sklearn.metrics import ConfusionMatrixDisplay

# plot confusion matrix
ConfusionMatrixDisplay.from_estimator(h_opt,  # trained optimal hypothesis model
                                      X_test,
                                      y_test,
                                      )
plt.xticks(rotation=45)
plt.show()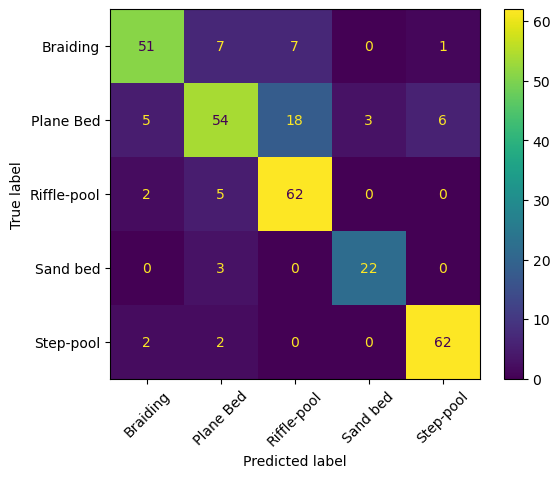
La matrice de confusion d’un modèle exact n’a que des entrées diagonales supérieures à zéro, alors que toutes les autres sont nulles. La matrice de confusion montrée ci-dessus montre que notre modèle SVM permet de bien prédire les morphologies du speed-pool (62 sur 66 observations vraies) et du riffle-pool (62 sur 69). Malgré le plus petit nombre d’observations, le modèle prédit aussi la plupart des observations de lit de sable correctement (22 sur 25). Toutefois, ces 25 observations de bancs de sable (supposées à 66 pools ou 86 observations de lit plan) sont peu nombreuses, ce qui rend les statistiques de banc de sable moins robustes. Ainsi, les observations du lit de sable sont déséquilibrées, et une solution pour augmenter la fiabilité pourrait être d’échantillonner plus d’unités morphologiques du lit de sable (comme expliqué ci-dessus).
Les performances les plus faibles concernent les morphologies du lit plan : seulement 54 des 86 observations du lit plan en vraie étiquette ont été prédites correctement. En particulier, le modèle prédit 18 fois riffle-pool et 6 fois step-pool, où en réalité (vraie étiquette), les unités morphologiques plan lit prévalaient. De plus, le modèle a prédit à tort qu’une observation de tresse serait une observation par pas. Ces confusions sont plausibles d’un point de vue physique parce que les lits d’avion représentent une morphologie transitoire entre les canaux de spread-pool et de raffle-pool Montgomery & Buffington, 1997.
- Montgomery, D. R., & Buffington, J. (1997). Channel-reach morphology in mountain drainage basins. Geological Society of America Bulletin, 109(5), 596–611. https://doi.org/10.1130/0016-7606(1997)109<;0596:CRMIMD>2.3.CO;2
- Recking, A., Piton, G., Vazquez-Tarrio, D., & Parker, G. (2016). Quantifying the morphological print of bedload transport. Earth Surface Processes and Landforms, 41(6), 809–822.
- Wyrick, J. R., & Pasternack, G. B. (2014). Geospatial organization of fluvial landforms in a gravel-cobble river: Beyond the riffle-pool couplet. Geomorphology, 213(Supplement C), 48–65. 10.1016/j.geomorph.2013.12.040
- Schwindt, S. (2017). Hydro-morphological processes through permeable sediment traps [Thesis No. 7655, Laboratory of Hydraulic Constructions (LCH), Ecole Polytechnique fédérale de Lausanne (EPFL)]. 10.5075/epfl-thesis-7655
- Franke, G. R. (2010). Multicollinearity. Wiley International Encyclopedia of Marketing.